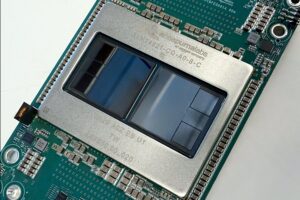
OpenAI 在其技术独立战略方面迈出了重要一步,发布了其定制 AI 处理器 Jalapeño 的首批测试结果。这款与博通合作开发的、专注于推理的芯片在两项关键指标上超越了英伟达 GB200 和 GB300 加速器:每瓦处理能力和响应速度。这些数据在 Hot Chips 大会上发布,并被彭博社和 The Verge 等媒体报道,使 OpenAI 在 AI 硬件竞赛中占据了前所未有的领先地位。
这可不是一件小事。此前,OpenAI 几乎完全依赖英伟达处理器来运行其模型,无论是在训练阶段还是推理阶段——也就是系统响应用户查询的阶段。借助 Jalapeño 芯片,该公司旨在降低运营成本并掌控其基础设施,但并非完全放弃英伟达。OpenAI 硬件负责人 Richard Ho 表示,这款芯片提供了他所谓的“两全其美”的优势:既能同时为众多客户端提供高容量支持,又能实现交互式应用的低延迟。

什么是墨西哥辣椒?它的作用原理是什么?
Jalapeño 是一款专用集成电路 (ASIC),从设计之初就专注于一项单一任务:运行预训练语言模型。与英伟达的通用处理器 GPU 不同,这款芯片针对推理阶段进行了优化,在该阶段,系统处理请求并生成响应。它并非用于训练模型,训练模型仍然是英伟达 GPU 的专属领域,OpenAI 也将继续使用英伟达 GPU 来完成这项任务。
该芯片的设计重点在于减少推理过程中常见的瓶颈,例如内存和计算单元之间的数据传输。据该公司称,Jalapeño 集成了一个大型计算单元和六个高带宽内存 (HBM) 块,从而实现本地数据存储,避免不必要的数据传输。此外,该芯片还能针对每个处理阶段激活合适的资源组合,从而提升人工智能的性能和能效。
与英伟达的基准测试结果
这些测试是在SemiAnalysis的公共平台InferenceX上进行的,该平台用于衡量人工智能系统在真实环境下的性能。OpenAI将Jalapeño与Nvidia GB200和GB300超级芯片的最佳成绩进行了比较,这些芯片是当时可用的基准测试芯片。结果表明,Jalapeño每瓦的人工智能工作量是GB200和GB300的1,5到1,9倍,端到端延迟降低了1,7到3,6倍。测试套件中使用的模型包括GPT-OSS 120B、DeepSeek R1和Kimi K3,涵盖了从开放权重模型到前沿模型的各种类型。
这些数据尤为重要,因为能效已成为该行业面临的主要挑战之一。人工智能数据中心消耗大量电力,降低单位工作量的能耗可以显著节省成本。据 Richard Ho 称,Jalapeño 的运行功耗约为 700 瓦,对于推理加速器而言,这是一个相对较低的数值。博通首席执行官 Hock Tan 表示,与传统 GPU 相比,Jalapeño 可以将运营成本降低约 50%。
与博通的合作及路线图
Jalapeño芯片的研发是OpenAI与博通公司于2025年10月宣布建立战略联盟的成果。博通公司贡献其在芯片设计、网络和制造方面的专业知识,而OpenAI则利用其人工智能模型加速设计流程。该芯片从最初设计到流片(即量产前的最后阶段)仅用了九个月时间——这对于先进半导体而言是一个创纪录的速度。
OpenAI 已在研发第二代处理器,第三代处理器也在开发中。该公司计划在 2026 年底前小规模部署首批搭载 Jalapeño 处理器的系统,并在 2027 年大幅扩展其应用范围。据彭博社报道,部署将在微软和其他合作伙伴的数据中心进行,预计到 2029 年,计算能力将达到 10 吉瓦。然而,目前公布的结果尚属初步,尚未在大规模生产环境中得到验证。
对市场和用户的影响
Jalapeño的到来并不意味着OpenAI放弃了Nvidia。该公司一直强调Nvidia仍然是其关键合作伙伴,尤其是在模型训练方面,并且由于计算能力的需求如此之高,OpenAI需要多家供应商的支持。事实上,OpenAI也与AMD和Cerebras合作,其战略是构建一个异构基础设施,将每个工作负载分配给最高效的硬件。
对于用户和开发者而言,这一消息意义重大。如果 Jalapeño 能够兑现承诺,未来 18 个月内,每个推理代币的成本可能会下降 30% 到 50%,从而使初创公司和企业能够提供价格更实惠、延迟更低的 AI 服务。此外,AI 芯片市场的竞争日益激烈,这可能最终转化为更优惠的价格和更多终端用户的选择。
最后值得注意的是,这些测试并未将Jalapeño与英伟达最新的Vera Rubin架构进行比较,该架构近期才开始出货。因此,当英伟达发布下一代产品时,Jalapeño的优势可能会减弱。即便如此,OpenAI取得的进展表明,人工智能行业正在进入一个新阶段,在这个阶段,定制硬件将扮演越来越重要的角色。效率和速度的竞赛才刚刚开始。